 Edemium
Десять тысяч документов можно рассортировать нейросетью примерно за два доллара. Кофе, который вы выпьете за чтением этой статьи, обойдётся дороже.
Осенью 2026 года OpenAI выпустила Decisions API — способ задать нейросети вопрос и получить не текст, а решение. За ответ не берут денег вообще. Для компаний, которые тонут во входящих документах и письмах, это меняет расчёты. Но только если настроить правильно: ниже — что это такое, сколько стоит на самом деле и семь ошибок, которые съедают всю экономию.
01 · Определение
Что такое Decisions API простыми словами
Decisions API — это способ спросить нейросеть так, чтобы она не писала текст, а выбрала ответ: вариант из вашего списка, вероятность «да» или оценку по шкале. Вместе с ответом она сообщает, насколько в нём уверена.
Обычная нейросеть на вопрос «что это за документ?» напишет абзац рассуждений. Decisions API вернёт одно слово из вашего списка — «счёт» — и число: насколько она уверена. Никаких «с одной стороны, с другой стороны».
«Добрый день. По договору № 114 оплата прошла 3 ноября, товар до сих пор не отгружен. Если до пятницы отгрузки не будет, будем вынуждены требовать возврат и неустойку».
На вход можно подать текст, изображения и данные в структурированном виде. Вопросов бывает три вида: «верно ли, что…» — в ответ вероятность; «что из списка» — в ответ вариант; «насколько по шкале» — в ответ оценка.
Цифры и возможности — по документации OpenAI на 20 ноября 2026 года. Тарифы меняются, перед расчётами сверяйтесь с первоисточником.
02 · Сравнение
Чем Decisions API отличается от обычного запроса к нейросети
Обычный запрос возвращает текст, и вы платите за каждое написанное слово. Decisions API возвращает решение, и платите вы только за прочитанное — поэтому он дешевле и, по данным OpenAI, примерно в десять раз быстрее.
Обычный запрос к нейросети
- Что возвращает
- Текст: ответ, пересказ, заполненную форму.
- За что платите
- За то, что прочитала, и за каждое написанное слово.
- Когда нужен
- Вытащить реквизиты и суммы, написать ответ клиенту, объяснить решение.
Decisions API
- Что возвращает
- Решение: вариант из вашего списка, вероятность «да» или оценку по шкале — и степень уверенности.
- За что платите
- Только за прочитанное. Ответ бесплатный.
- Когда нужен
- Рассортировать, направить, проверить условие, расставить приоритеты — на тысячах документов.
Это не замена обычным моделям, а новая первая ступень. Большинство рутинных решений в компании — не «напиши», а «определи»: что это, куда это, срочно ли. Раньше для них использовали тот же инструмент, что и для написания текстов, — и платили за слова, которые никому не нужны.
03 · Применение
Что это даёт бизнесу: пять задач
Decisions API подходит для сортировки и проверки больших потоков: определить тип документа, направить обращение в нужный отдел, проверить условие, расставить приоритеты и отсеять лишнее.
- 1
Сортировка входящих документов
Счёт, акт, договор, претензия, резюме или реклама — система раскладывает поток по типам без человека.
- 2
Маршрутизация обращений
Письмо или сообщение сразу попадает в нужный отдел: продажи, бухгалтерия, поддержка, юристы.
- 3
Проверка условий
Есть ли на скане подпись и печать, упомянут ли срок оплаты, похоже ли обращение на повторное списание — вопросы с ответом «да или нет» и вероятностью.
- 4
Приоритеты
Насколько срочно, насколько недоволен клиент, насколько высок риск — оценка по вашей шкале, чтобы люди начинали с важного.
- 5
Отсев лишнего
Отфильтровать спам, дубли и нерелевантное до того, как на них потратит время человек или дорогая нейросеть.
04 · Деньги
Сколько стоит разобрать 10 000 документов
Сама сортировка десяти тысяч текстовых документов обходится примерно в два доллара — при цене $0,10 за миллион токенов на входе и бесплатном ответе. Основные расходы — не запросы, а настройка, проверка и второй шаг, где из документов достают данные.
Запросы стали настолько дешёвыми, что перестали быть главной статьёй расходов. Деньги теперь уходят на то, чтобы система принимала правильные решения: описать критерии, собрать примеры, подобрать пороги, связать с вашими программами.
Хотите точный расчёт на своих документах? Пришлите пару примеров — посчитаем.
Посчитать мой поток05 · Не из новостей
Три приёма, которые делают разбор ещё дешевле и надёжнее
Задавайте все вопросы по документу одним запросом, ставьте общие правила в начало запроса, чтобы они шли из кэша, и подбирайте порог уверенности отдельно для каждого типа решения — по цене ошибки.
- 1
Много вопросов за одно чтение
В один запрос помещается до 400 вопросов. Документ при этом оплачивается один раз. Тип, отдел, срочность, наличие подписи — всё одним обращением, а не четырьмя.
- 2
Правила — в начало, документ — в конец
Одинаковое начало запроса берётся из кэша и стоит в десять раз дешевле: $0,01 вместо $0,10 за миллион токенов. Условие — повторяющаяся часть длиной от 1 024 токенов. Поэтому описание категорий и правил ставят первым, а сам документ последним.
- 3
Порог уверенности — по цене ошибки
Пропустить претензию дороже, чем лишний раз показать письмо юристу. Значит, для «претензии» порог низкий: малейшее подозрение — человеку. А для «рекламы» высокий: в корзину уходит только очевидное.
06 · Схема
Как устроить разбор документов: две ступени
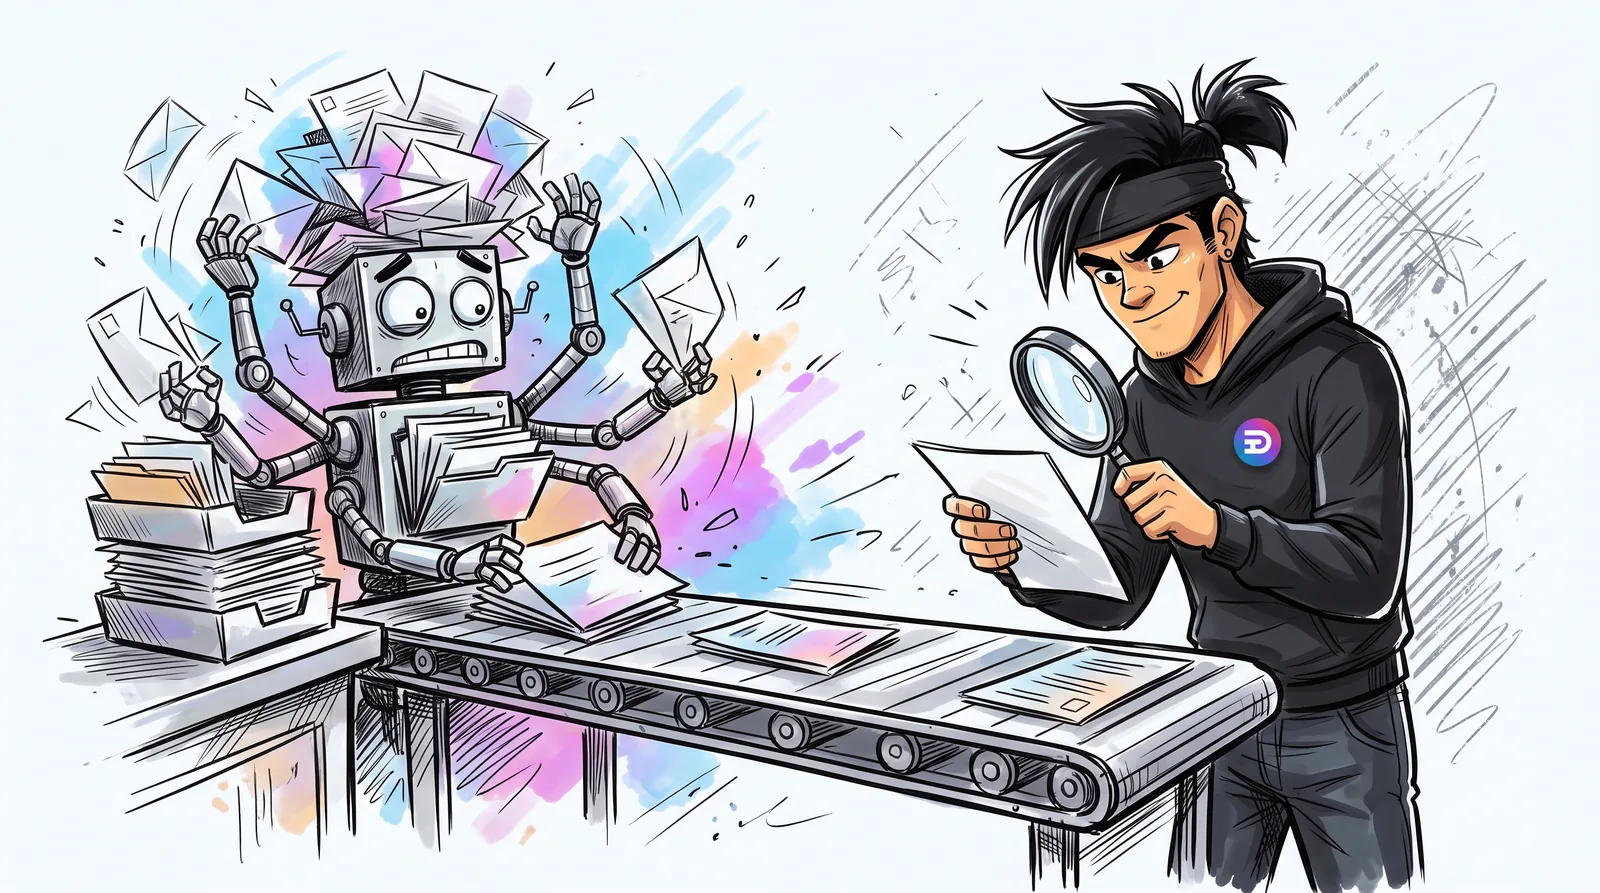
Сначала дёшево рассортировать весь поток через Decisions API, потом обычной моделью прочитать только те документы, из которых нужно достать данные. Сомнительные случаи уходят человеку.
Поток
Все документы и обращения попадают в одну очередь.
Сортировка
Decisions API определяет тип, отдел и срочность каждого.
Чтение
Обычная модель достаёт реквизиты и суммы — только там, где это нужно.
Человек
Смотрит то, в чём система не уверена, и необратимые решения.
Смысл в том, чтобы дорогой инструмент работал только там, где он нужен. Если из тысячи входящих писем реквизиты нужно доставать из двухсот, незачем читать «дорого» все тысячу.
Как выглядит разбор входящих целиком — на странице автоматизации бизнес-процессов.
Соберём такую схему под ваш поток документов — от сортировки до записи в вашу систему.
Обсудить схему07 · Грабли
Семь ошибок настройки, которые съедают всю экономию
Главные ошибки — пытаться вытащить этим инструментом реквизиты, принимать любой ответ без порога уверенности и запускать без проверки на своих документах. Технология дешёвая, а ошибки в документах — нет.
- 01
Пытаются вытащить им реквизиты
Decisions API выбирает из готовых вариантов. ИНН, сумму или дату он не вернёт — в документации OpenAI прямо сказано, что для извлечения полей нужен другой инструмент.
Чем заканчивается. Неделя экспериментов и вывод «не работает», хотя инструмент просто применили не к той задаче.
Как правильноДелить работу на две ступени: сначала дёшево рассортировать всё, потом обычной моделью прочитать только нужные документы. - 02
Верят любому ответу
Система возвращает не только решение, но и уверенность. Её игнорируют и принимают всё подряд.
Чем заканчивается. Договор уходит в папку «реклама», претензия — в продажи. Узнают, когда срок ответа уже прошёл.
Как правильноЗадать порог: выше — принимаем автоматически, ниже — отправляем человеку. Порог подбирать на своих размеченных примерах, как и советует OpenAI. - 03
Не дали варианта «другое»
В списке пять типов документов, а пришёл шестой. Системе приходится выбрать что-то из пяти.
Чем заканчивается. Нестандартные документы тихо попадают в чужие категории и теряются.
Как правильноВсегда добавлять вариант «другое» и отдельную очередь для таких случаев. - 04
Критерии написаны размыто
«Важный ли это документ?» — у каждого сотрудника свой ответ, у нейросети тоже.
Чем заканчивается. Оценки скачут, результатам перестают доверять и возвращаются к ручной сортировке.
Как правильноФормулировать проверяемо: «в тексте есть требование оплаты со сроком», «на странице есть подпись». Уровни шкалы — чётко различимые. - 05
Шлют сканы как есть
Каждую страницу отправляют картинкой в полном размере, хотя в файле уже есть текст.
Чем заканчивается. Счёт вырастает в разы, и «копейки» превращаются в заметную строку расходов.
Как правильноГде есть текстовый слой — передавать текст. Картинки — только для того, что видно глазами: подпись, печать, повреждения. PDF-файлы напрямую этот интерфейс не принимает: их нужно заранее превращать в текст или изображения страниц. - 06
Забыли про персональные данные
В документах паспорта, адреса, телефоны клиентов — и всё это уходит на зарубежные серверы.
Чем заканчивается. Нарушение закона о персональных данных со всеми последствиями.
Как правильноДо запуска решить вопрос с юристом. Варианты: обезличивать данные перед отправкой, использовать российские нейросети или свою модель для чувствительных документов. - 07
Запустили без проверки на своих документах
Посмотрели пример из документации, убедились, что работает, и включили на весь поток.
Чем заканчивается. Реальная точность на ваших документах неизвестна. Ошибки всплывают по одной, уже в работе.
Как правильноСобрать 200–300 своих документов с правильными ответами, прогнать, посчитать ошибки по каждому типу — и только потом запускать.
08 · Данные
Можно ли использовать Decisions API в России
Технически — да, но это зарубежный сервис: данные обрабатываются за пределами России. Если в документах есть персональные данные, вопрос нужно решить до запуска — обезличиванием, российскими нейросетями или своей моделью.
Мы не юристы и не заменяем их консультацию, но на практике рабочих путей три. Первый — убирать из документов персональные данные перед отправкой: для сортировки они обычно не нужны. Второй — использовать тот же подход на российских нейросетях: сам принцип «сначала выбрать, потом читать» работает и там, хотя цены и точность другие. Третий — чувствительные документы обрабатывать моделью на своём сервере.
Часто итоговая схема смешанная: открытые документы идут через самый дешёвый инструмент, документы с персональными данными — через российский контур.
Есть персональные данные и сомнения, как с ними быть? Разберём варианты под вашу ситуацию.
Задать вопрос09 · План
С чего начать
Посчитайте поток, запишите решения, которые сейчас принимают люди по каждому документу, соберите двести-триста примеров с правильными ответами и запустите систему на части потока параллельно с сотрудниками.
- 1
Посчитайте поток
Сколько документов и обращений приходит в месяц и сколько времени людей уходит на то, чтобы их просто разобрать.
- 2
Запишите решения, которые принимаются по каждому
Что это, кому, срочно ли, всё ли на месте. Это и есть будущие вопросы к системе.
- 3
Соберите примеры с правильными ответами
Двести-триста документов из архива. Без них нельзя ни проверить точность, ни подобрать порог уверенности.
- 4
Запустите на части потока
Параллельно с людьми, неделю-две. Сравните решения системы и сотрудников.
10 · Вопросы
Частые вопросы о Decisions API
Decisions API — это новая нейросеть?
Нет, это новый способ обращаться к нейросети OpenAI. Модель не пишет текст, а возвращает решение: вариант из списка, вероятность или оценку по шкале.
Может ли Decisions API достать из документа ИНН, сумму и дату?
Нет. Он только выбирает и оценивает. Для извлечения данных нужна обычная модель с заданным форматом ответа — это второй шаг после сортировки.
Принимает ли Decisions API файлы PDF и сканы?
Текст и изображения — да, файлы PDF напрямую — нет. Документ нужно заранее превратить в текст или в изображения страниц.
Насколько точны решения?
OpenAI не публикует общих цифр точности — она зависит от ваших документов и формулировок. Поэтому проверка на собственных примерах обязательна до запуска.
Сколько времени занимает внедрение?
Наши проекты занимают от недели до полутора месяцев. Срок зависит от числа типов документов и программ, с которыми нужно связать разбор.
Можно ли сделать то же самое на российских нейросетях?
Сам подход — да: сначала дёшево выбрать, потом читать только нужное. Отдельного такого же интерфейса у российских моделей может не быть, поэтому цена и скорость будут другими.
Читать дальше